
58
SEO
Что такое канонический URL
Когда только входишь в SEO, слышишь про дублированный контент примерно так же часто, как про кофеин — вроде и все страшилки ясны, а вот реальность настигнет в самый неожиданный момент. У меня этот момент случился довольно банально: в Google Search Console очередь из почти одинаковых страниц — словно очередные призраки на проверке. И каждый с амбициями занять топовое место в выдаче. После этого канонический URL перестал быть для меня абстракцией из учебников и превратился в конкретную палочку-выручалочку: без неё нормальная жизнь сайта просто невозможна.
Попробую объяснить “по-человечески”
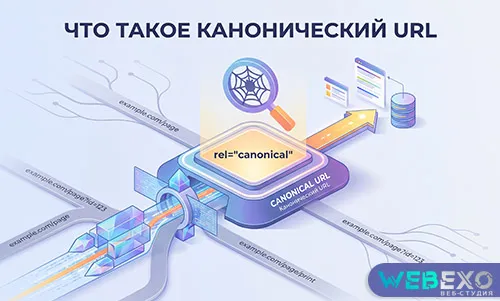
Что вообще такой этот ваш канонический URL? Представьте: у вас один товар и три разных пути к нему:
- https://mysite.ru/tovar
- https://mysite.ru/tovar?utm_source=email
- https://www.mysite.ru/tovar/
Для обычного посетителя это вообще не имеет значения — открылась одна и та же страница товара, он доволен. А вот поисковик царапает затылок: “Ммм… вижу три документа — а содержание-то копия!” Начинается путаница из раздельных “единиц учета”, краулинговый бюджет тратится на хождение по кругу, рейтинг размазывается тонким слоем. А ещё иногда поисковик вполне может выбрать для индексации версию, которую вы сами никогда не захотели бы выставлять напоказ.
Вот здесь canonical-тег становится чем-то вроде таблички на двери: “Вот эта страница главная, остальные — второстепенные копии”.
Пример добавления:
<link rel="canonical" href="https://mysite.ru/tovar" />Поместили тег внутрь — и дали явный сигнал роботам, кого считать хозяином.
Почему этим стоит заниматься именно сейчас
Последние годы поисковые системы научились распознавать дубли гораздо тоньше — а количество сценариев генерации дублей только растет! CMS плодят урлы налево и направо, фильтры, сортировки, пагинация, потоки трафика из рекламы, UTM-метки… В результате на одну страницу контента вдруг находится 5–10, а то и 15 адресов — и все претендуют на жизнь.
Вспомнил магазин оборудования — карточка одного товара могла открываться аж пятнадцатью способами благодаря фильтрам, категориям и меткам кампаний. Без правильного canonical выдача дергалась как ёжик на батуте: сегодня Яндекс и Google проиндексировал одну версию карточки, завтра другую.
Как сделать по уму
Наиболее универсальный путь — разместить внутри каждой страницы строчку:
<head>
  <link rel="canonical" href="https://mysite.ru/blog/statya" />
</head>
Обратите внимание: используем абсолютный путь (с протоколом), иначе получится ерунда.
Бывают ситуации с PDF или изображениями — туда HTML не вставить. Помогает заголовок ответ сервера:
Link: <https://mysite.ru/document.pdf>; rel="canonical"Где чаще всего промахиваются
- Ставят canonical на страницу-фантом (которая давно удалена). На выходе все теряют.
- Делают цепочки ссылок (“А” канонизирует “Б”, а та — “В”). Поисковики тут быстро теряют нить повествования.
- Указывают canonical на откровенно другой контент (в попытке что-то схитрить).
- Две версии сайта для мобилок/десктопа друг друга игнорируют, нужно использовать ещё парный тег alternate.
Проверять надо регулярно
Я всегда захожу в раздел страницы Search Console, там видно глазами алгоритма, какой адрес выбран главным. А затем проверяю проблемные адреса через «Проверку URL»: инструмент показывает, как Google обработал страницу, какой canonical указан пользователем и какой canonical выбран Google.
Из десктопных инструментов обожаю Screaming Frog: он за пару минут наматывает по всему сайту паутину реальных canonical-ссылок и даёт понять — где не указали вовсе, где случайно расхождение.
Выводы без официоза
Canonical-ссылки — это что-то вроде регулярной чистки зубов для вашего сайта. Один раз прописал и забыл? Нет уж! У крупных или быстро меняющихся проектов ежемесячно устраиваю ревизию. Инфосайты или блоги можно проверять поквартально. Эти мелочи экономят кучу ресурса и реально влияют на то, чтобы одна страница крутилась в топе, а не десяток её двойников возились где-нибудь в хвосте поиска.
В общем: canonical теперь воспринимаю не как обузу — это просто привычка делать сайт крепче и чище.


